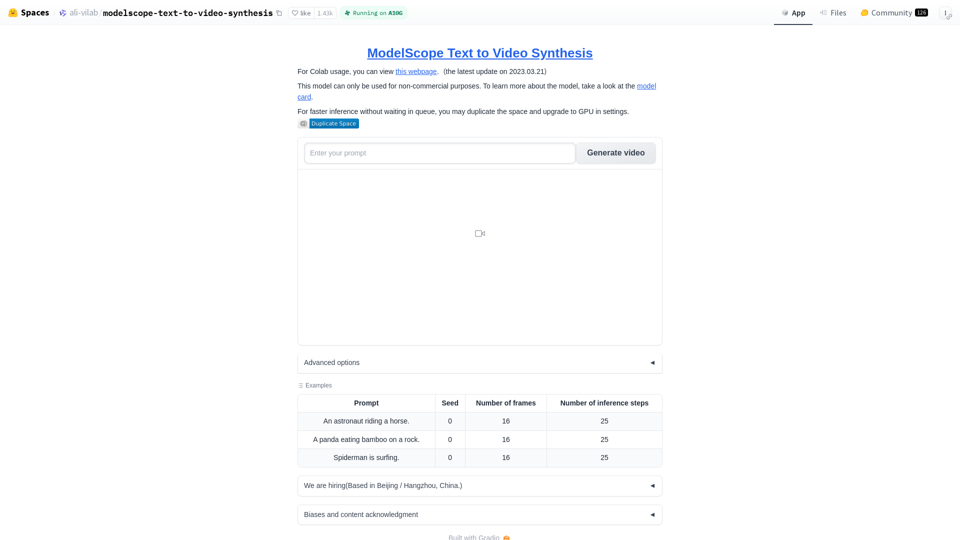
Le modèle ModelScope Text To Video Synthesis est un espace Hugging Face créé par ali-vilab qui permet de générer des vidéos à partir de textes. Ce modèle utilise les dernières avancées en matière de modèles de langage pour produire des vidéos de haute qualité.
Fonctionnalités
Ce modèle offre de nombreuses fonctionnalités, notamment la capacité de générer des vidéos à partir de textes courts ou longs, la prise en charge de plusieurs formats de sortie et la possibilité d'ajouter des effets visuels et sonores.
Utilisation
Pour utiliser ce modèle, il suffit de fournir le texte que vous souhaitez transformer en vidéo et de choisir les options de sortie souhaitées. Le modèle prendra en charge le reste et générera une vidéo de haute qualité.
Prix
Ce modèle est actuellement disponible gratuitement, mais les utilisateurs peuvent être facturés en fonction de leur utilisation.