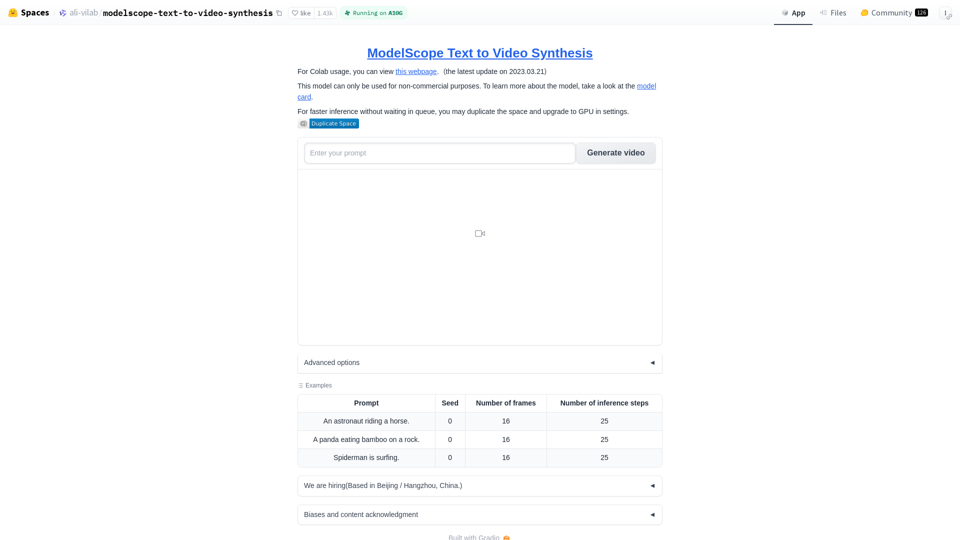
이 모델스코프 텍스트 투 비디오 합성은 Hugging Face의 ali-vilab 스페이스에서 개발된 혁신적인 기술입니다. 이 기술은 텍스트를 입력받아 비디오를 생성하는 것과 같이 인간의 상상력에 가까운 결과를 얻을 수 있습니다.
특징
이 모델スコ프 텍스트 투 비디오 합성의 주요 기능은 다음과 같습니다. 다양한 텍스트 입력에 대응할 수 있는 다중 모드 지원, 고해상도 비디오 생성, 사용자 친화적 인터페이스 등입니다.
사용
이 모델스코프 텍스트 투 비디오 합성을 사용하려면 다음 단계를 따르면 됩니다. 텍스트 입력, 모델 선택, 비디오 생성 등입니다.
가격
이 모델스코프 텍스트 투 비디오 합성의 가격은 다양하게 제공됩니다. 무료 버전, 프리미엄 버전 등으로 나누어져 있습니다.